这几年我们使用大模型的方式几乎形成了固定范式:
无论是 ChatGPT、Coding Agent,还是各种 Agent Framework,底层核心仍然是一个 Text Generation Model。
模型首先生成 Token,然后我们再想办法让这些 Token 变成程序能够理解的结构。
但很多软件场景根本不需要模型“说话”。
例如:
这个请求应该交给哪个团队?
这条告警严重吗?
这个 Tool Call 是否存在风险?
这封邮件需要回复吗?
这条内容是不是垃圾信息?
这些问题需要的不是一段自然语言,而是一个判断。
这正是 TypeSafe AI 最近发布的 Jev 想解决的问题。
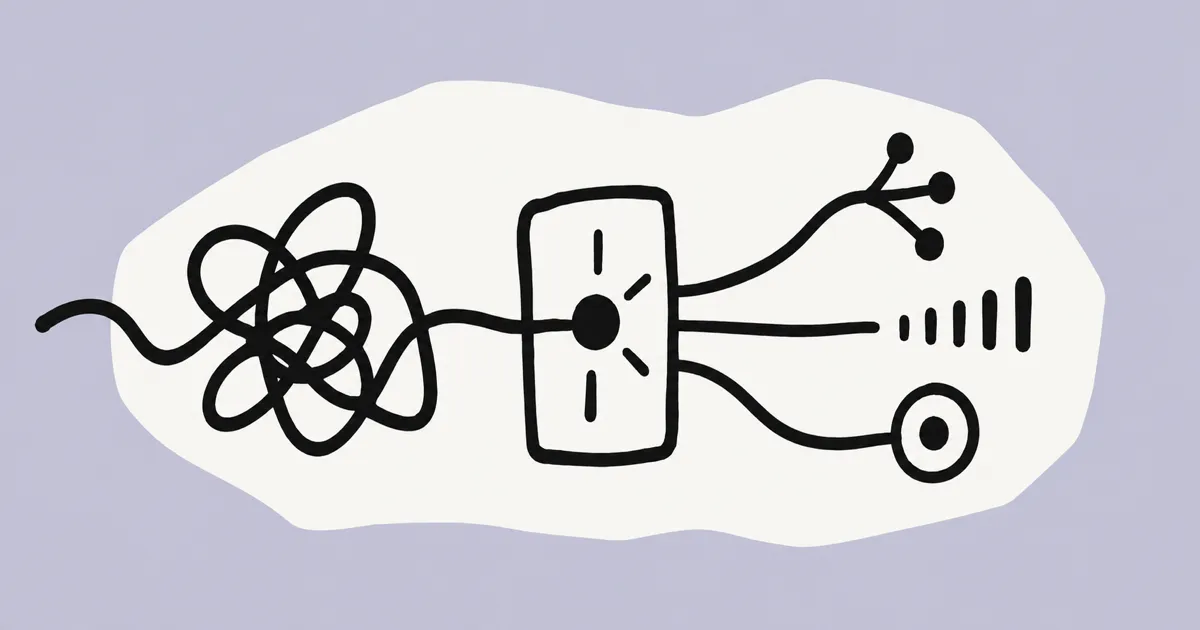
2026 年 9 月 15 日,TypeSafe AI 发布了首个所谓 System One Model:Jev。它不以生成字符串为主要目标,而是接收程序状态和预先定义的问题,直接返回结构化判断。TypeSafe 将它概括为:
unstructured state in → typed probabilistic decisions out
也就是说:
而不是:
这看起来只是少生成了一段文字,但背后的编程模型其实完全不同。
理解 Jev:一个 AI 版的模糊 if 语句
我觉得理解 Jev 最简单的方法,是把它想象成:
传统程序可以轻松处理:
因为 cpuUsage > 90 是确定性的。
但现实中的大量判断并没有这么清晰。
例如:
或者:
你当然可以继续堆规则:
问题是语言和软件状态永远存在模糊性。
这类事情 LLM 很擅长判断,但传统 LLM 又显得太重:让一个模型生成几十甚至几百个 Token,只为了最后得到一个 true,多少有点绕。
Jev 的思路就是直接训练一个模型来做这种判断。
TypeSafe 官方文档目前提供三种基本问题类型:Choice(从有限选项中选择)、Score(按规则评分)、Noul(判断一个陈述成立的概率)。
光看类型定义比较抽象,下面用同一批客服工单,分别喂给三种类型,点一下切换消息就能看到返回结构的变化。
这条消息应该路由给哪个团队?
帮帮我!我的打款已经连续失败 3 天了,客户都在投诉。
choice: technical · confidence: 0.74示意数据,用于展示 Choice 的返回结构(choice + probabilities + confidence),不代表真实调用结果。
查看原始 JSON
输入
{}输出
{}客户在这条消息里的情绪有多激烈?
帮帮我!我的打款已经连续失败 3 天了,客户都在投诉。
score: 1.4示意数据,用于展示 Score 的返回结构(score + legend + probabilities + confidence),不代表真实调用结果。
查看原始 JSON
输入
{}输出
{}这条消息是否需要立即升级给人工处理?
帮帮我!我的打款已经连续失败 3 天了,客户都在投诉。
noul: 0.94倾向于「是」,建议升级示意数据,用于展示 Noul 的返回结构(仅有 noul 一个字段,没有单独的 confidence),不代表真实调用结果。
查看原始 JSON
输入
{}输出
{}并且这三个问题可以在同一次请求里并行计算——上面三个 Demo 用的其实是同一条工单:官方文档里就是用它同时问 department(Choice)、frustration(Score)、is_urgent(Noul),一次调用全部拿到。
软件拿到这些值之后,不需要再理解任何自然语言,直接执行代码即可。
Jev 和 Structured Output(JSON Mode)的区别
第一反应可能是:
LLM 的 JSON Mode / Structured Output 不也能做到?
表面上确实很像。
例如让一个 LLM 返回:
但本质还是:
模型仍然在生成一个字符串,只是这个字符串被 Schema 约束了。
而 Jev 从模型接口层面就不把“生成任意字符串”作为目标。它的输出空间事先已经定义。
TypeSafe 在官方对比表里将这种区别描述为:LLM 面向人类生成文本,而 System One Model 面向软件生成 typed decisions。Jev 的多个判断还可以并行完成,而不是逐 Token 自回归生成。
因此它特别适合另外一种 AI 工作负载:高频、简单、模糊、需要程序立即消费的判断。
“不会产生幻觉”不代表“不会判断错”
TypeSafe 官方也强调,Jev 不会产生传统意义上的幻觉,因为输出只能落在预定义的数据结构中;Schema matching 保证不会产生类型错误。
但这并不意味着 Jev 永远正确。它仍然可能把一个 Bug 判断成 Feature,也可能错误估计风险。
更准确的理解应该是:不会输出非法答案 ≠ 不会输出错误答案。
例如你规定 Choice 的选项只有 ALLOW、ASK、BLOCK 三种,Jev 不会突然回答 “I think you should probably ask the user…”——它一定会落在这三个允许的选项里。
解决“可能判断错误”这件事,靠的是 probability + confidence + software policy。
比如:
AI 不再拥有整个工作流的控制权,只负责判断这一件事。而「什么时候相信 AI」「什么时候升级给人」「最终允许做什么」,全部由普通代码决定。
Jev 和 Agent 是互补关系,不是替代关系
现在很多 Agent 的架构是:
这里实际上隐藏着大量小判断:
这个 Tool Call 是否合理?
这条搜索结果相关吗?
这个 Observation 是否值得放进 Context?
这个任务应该交给哪个 Sub-Agent?
当前步骤是否已经完成?
这个操作风险高不高?
如果所有问题都调用一个大型推理模型,会非常昂贵,而且延迟会不断累积。
于是可以变成:
大型模型负责真正需要生成、规划、推理、编码、解释的任务。
Jev 则负责那些 Should I? Which one? How much? Is this true? 类型的判断。
这可能比“让一个 Agent 解决所有事情”的架构更加工程化。
为什么现在值得关注 Jev 这类模型
TypeSafe 官方公布的 Jev 定价为每百万输入 Token 0.042 美元,输出不单独收费;服务端端到端延迟大约为 70~500ms。需要注意,这些性能数字来自 TypeSafe 自己目前的测试和服务环境,因此更适合作为厂商公布指标,而不是普适 Benchmark 结论。
让我觉得有意思的,不是“便宜了多少倍”,而是模型的使用单位发生了变化。
以前我们思考:
这里能不能放一个 LLM?
未来可能会变成:
这里是不是有一个无法用规则准确表达的 if?
如果答案是 Yes,那么这里就可能存在一个小型 AI Decision Model 的位置。
传统代码负责确定性,大型 LLM 负责复杂推理和生成,而 Jev 这样的模型,则试图填补两者之间那一大片过去很难处理的区域:
它不一定是在创造一种更聪明的聊天机器人,更像是在尝试创造一种新的软件原语:
如果这种模式最终成立,那么未来很多软件里的 if,可能真的会开始带一点智能。